「AIエージェント」という言葉を、ニュースやSNSで見かける機会が増えました。ChatGPTのようなチャットAIはすでに使っているけれど、「エージェント」と名のつくものは何が違うのか、自分も学ばないと取り残されるのか、判断がつかないまま情報だけが増えている——という状態の方も多いのではないでしょうか。
結論からいうと、AIエージェントを学ぶべきかどうかは、プログラミングができるかどうかではなく、固定された手順で十分か、途中の判断をAIに任せる必要があるかによって変わります。全員が学ぶべきものでもなければ、全員が避けるべきものでもありません。
この記事では、辞書的な定義の説明やツール比較ではなく、あなたが今どの状態に近く、次に何をすべきかを判断するための基準を整理します。
なぜ「AIエージェントとは何か」を読んでも、学ぶべきか分からないのか
AIエージェントを検索すると、多くは「AIエージェントとは、自律的にタスクを遂行するAIのことです」といった定義の説明か、「おすすめツールN選」といったツール比較記事にたどり着きます。
どちらも、読んだ直後は分かった気になりますが、「では自分は学ぶべきなのか」には答えていません。定義記事は概念を説明するだけで、あなたの業務量や任せたい範囲を考慮していません。ツール比較記事は、すでに「使う」と決めた人向けの情報です。
必要なのは、定義でもツール一覧でもなく、「自分の仕事は固定手順で足りるのか、途中の判断をAIに任せる必要があるのか、任せる場合どこで人間が確認するのか」を判断する基準です。
ハタラクエ式「AIに、どこまで任せるか」の境界線|まず自分の状況を確認する
AI開発企業のAnthropicは、AIシステムを2種類に区別しています。ひとつは、あらかじめ決めた手順(コードパス)に沿ってLLMとツールを動かす「Workflow」。もうひとつは、LLM自身がタスクの進め方やツールの使い方を動的に判断する「Agent」です(Anthropic「Building Effective Agents」より)。
つまり「AIエージェント」とは、AIに任せる作業の手順を、人間があらかじめ全部決めておくのではなく、AI自身にある程度考えさせて進めてもらう仕組みを指します。同社は、タスクの目的が明確であれば、エージェントは人間が逐一指示しなくても計画と実行を進められるとしています。
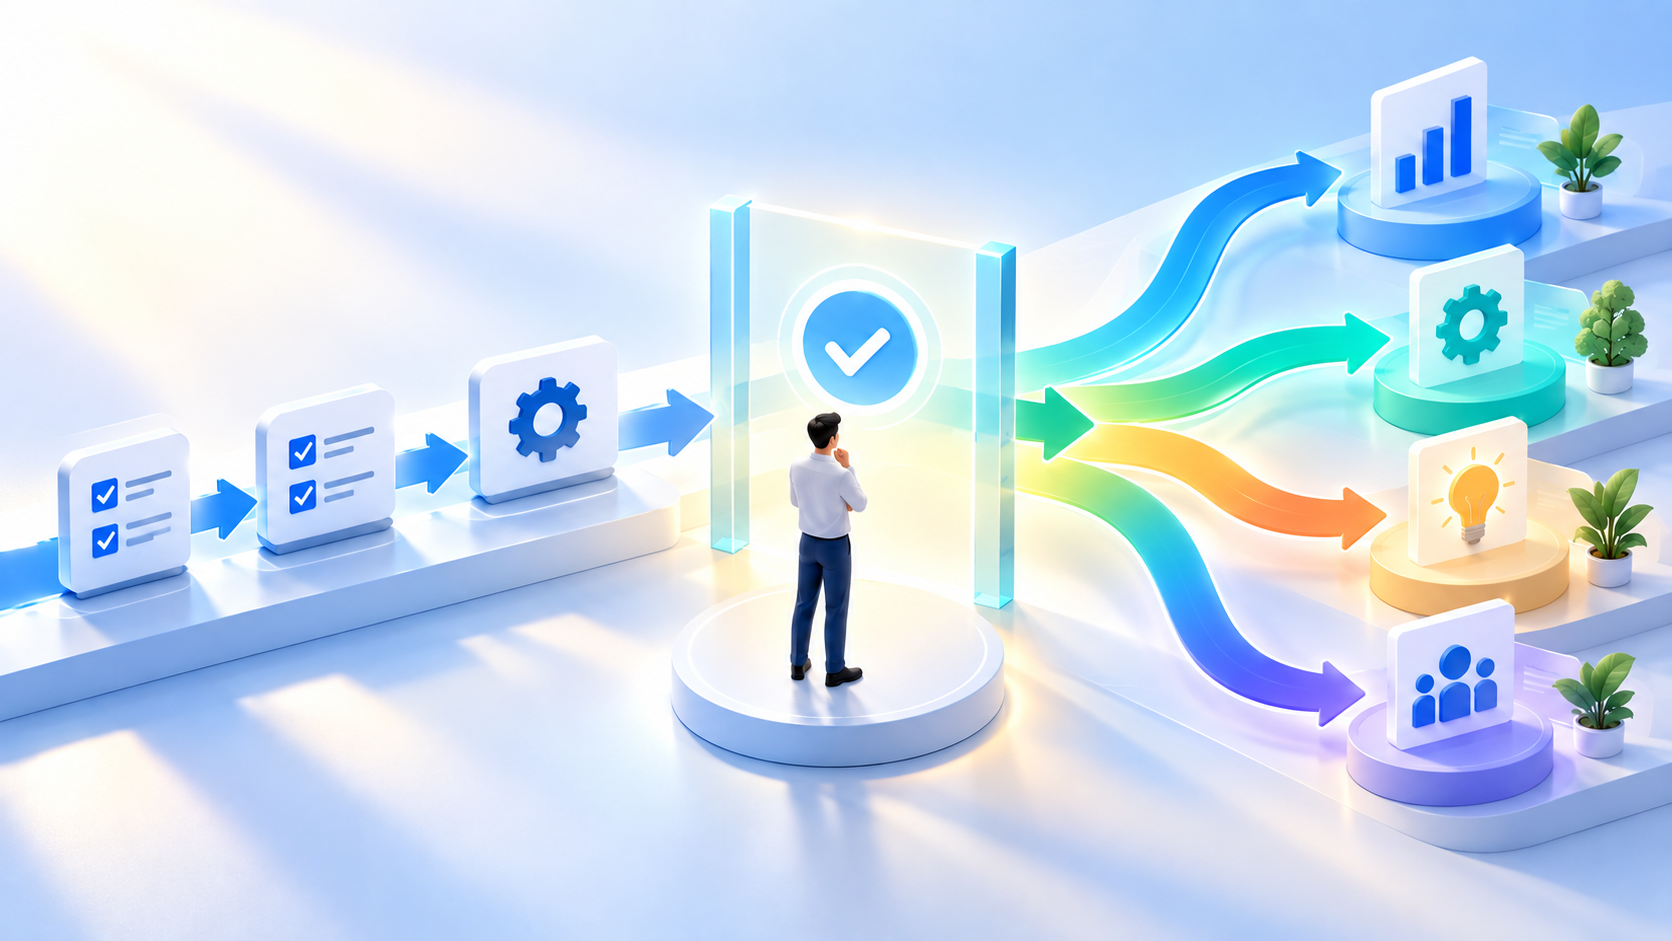
この「どこまで自分で考えて進めてもらうか」という度合いは、0か100かではなく段階があります。ハタラクエでは、非エンジニアの仕事における関わり方を、次の3つの状態に整理しました。これは公的機関や特定企業が採用した公式の分類ではなく、判断の起点として使うための独自の整理です。
なお、A〜Cは能力の優劣ではありません。どれも独立して合理的な着地点です。
| 状態 | 一言で言うと |
|---|---|
| A|固定手順のまま人力・単発利用で十分 | 繰り返し頻度が低く、都度AIに聞けば足りる |
| B|固定手順をノーコードで自動化したい | 手順は決まっている繰り返し作業を、コードなしで自動実行したい |
| C|途中の判断をAIに動的に任せたい | 状況に応じて次の手順が変わる複数ステップを、AI自身に判断させたい |
なお、任せたい作業の対象そのものがコード(開発・データ処理など)である場合は、A〜Cとは別の軸で判断します。これについては後述します。
以下、それぞれの状態を具体的に見ていきます。
状態A|固定手順のまま人力・単発利用で十分
具体的な業務状況:メールの下書き、資料の要約、企画の壁打ちなど、1回の質問と1回の回答で完結する使い方が中心。
AIに任せたい作業:単発の生成・要約・壁打ち。
学習が必要な範囲:プロンプトの書き方の基本程度で十分。
人間が確認すべき部分:出力内容そのもの。1回ごとに自分の目で見てから使うかどうかを判断しているため、B以降のような「確認の設計」自体は必要ありません。
次に取る行動:無理にエージェントを学ぶ必要はない。生成AI全体の学習の進め方に迷う場合は、生成AIの学習ロードマップを先に確認するのがおすすめです。
Aのままで十分と判断できる条件:同じ手順を繰り返す頻度が低く、かつAIに毎回同じ判断や確認を求めていない場合は、Aのままで十分です。繰り返し頻度が高い場合は、複数のツールを使っているかどうかに関わらず、状態B(ノーコードでの定型自動化)を検討する対象になります。
状態B|固定手順をノーコードで自動化したい
具体的な業務状況:「毎週この形式でレポートをまとめる」「問い合わせフォームの内容を毎回同じ形式で転記する」など、手順は決まっているのに、毎回手作業でやっている繰り返し業務がある。
AIに任せたい作業:決まった手順の自動実行。手順自体は人間が設計し、実行だけをツールに任せる。
学習が必要な範囲:Power Automateでワークフローの流れを構成し、必要に応じてAI BuilderのAI機能を組み込むという使い方。Microsoft公式は、こうした構成の一部をコードを書かずに扱えるとしていますが、すべての操作や機能がコード不要というわけではありません。
人間が確認すべき部分:自動化した処理が意図通りに動いているかの定期チェック。Aと異なり実行が人間の目を通さず自動で進むため、確認のタイミングをあらかじめ設計しておく必要があります。
次に取る行動:まずは1つの繰り返し業務をノーコードツールで試してみる。
Bのままで十分と判断できる条件:ノーコードツールで自動化できる範囲の手順しか扱っておらず、「次はこの結果を見てAIに判断させたい」という要望が出てきていない場合、Cに進む必要はありません。
状態C|途中の判断をAIに動的に任せたい
具体的な業務状況:「情報を集めて→内容を判断して→次のアクションを決めて実行する」のように、複数の工程を横断してAIに任せたい場面がある。かつ、途中の判断部分を人間が毎回細かく指示するのではなく、AI自身にある程度任せたい。
AIに任せたい作業:複数ツール・複数手順にまたがる一連の処理。次に何をするかの判断そのものをAIに委ねる部分が含まれる。
必要な学習:
- 任せたい業務を、工程(何を→どう判断する→次に何をする)に分解できること
- 使うツールと、それぞれに与える権限の範囲を把握していること
- 「成功」「失敗」をどう判定するかの条件をあらかじめ決めておくこと
- どこで処理を止め、人間に確認を戻すか(確認・停止地点)を決めておくこと
人間が確認すべき部分:外部への送信、データの更新・削除など、誤った場合の影響が大きい操作の前には、人間の確認地点を設けます。影響の大きさは、AIに与える実行権限の範囲、扱う情報が機密情報・個人情報を含むかどうか、操作の可逆性、後続システムへの自動連携の有無、誤操作が及ぶ範囲、そして社内規程や利用環境によって変わります。確認を省略できるのは、これらを踏まえて影響範囲を限定できると判断できる場合(機密情報を含まず、後続処理へ自動連携されず、容易に元へ戻せるテスト用の下書き作業など)に限られます。この基準はハタラクエが提示する実務上の判断であり、Anthropicがすべての操作に人間の確認を義務付けているわけではありません。
自律性が上がる場面:ここが状態Bとの決定的な違いです。Bは「手順は固定、実行だけ自動」ですが、Cは「次に何をするかの判断そのものをAIに委ねる」割合が増えます。Anthropicの定義に沿えば、この時点でWorkflow寄りの使い方からAgent寄りの使い方へ移行し始めている状態です。
次に取る行動:この段階から、「AIにどこまで自律的に判断させ、どこで人間が確認するか」という設計そのものが重要になります。次の見出しで詳しく扱います。
進む必要がないと判断できる条件:任せたい業務の失敗時の影響が小さく(外部への影響がない、やり直しが容易など)、負担も低い場合は、無理にここへ進む必要はありません。逆に、頻度が低くても、一度の失敗が外部への誤送信やデータ損失につながるような業務であれば、頻度に関わらず確認・停止地点の設計を先に検討すべきです。
対象そのものがコードである場合|別の軸で判断する
ここまでのA〜Cは、「手順が固定か、途中の判断をAIに動的に任せるか」という軸で整理してきました。これとは別に、そもそも任せたい作業の対象自体がコード(開発・データ処理・社内ツール作成など)である場合は、もう一つ別の判断が必要になります。
コーディングエージェントを使うかどうかは、A〜Cの延長にある「より高度な段階」ではありません。「作業対象がコードかどうか」という、独立した軸の話です。ノーコードで定型業務を自動化する状態Bの人が、必ずしもコーディングエージェントへ進む必要があるわけではありません。
プログラミングそのものを学ぶべきかどうかは、プログラミング学習の要否で判断できます。Claude Codeのようなコーディングエージェントを実際に導入する場合の具体的な手順は、Claude Code導入ガイドで解説しています。
「自律的に動かす」と「人間が確認する」の境界
A〜Cのどの状態でも共通して考えておくべきなのが、「AIにどこまで自律的に進めさせ、どこで人間の確認を挟むか」という設計です。
Anthropicは、エージェントの設計として、チェックポイントや障害発生時に人間のフィードバックのために一時停止できる、という選択肢があるとしています。これは「必ず人間の確認が入る」という保証ではなく、そのような設計が可能である、という位置づけです。実際に確認を挟むかどうかは、都度の設計次第です。
そしてAnthropicは、自律的に動くAIシステムほど、コストが増加し、小さな誤りが積み重なる(compounding errors)リスクがあることも明記しています。だからこそ、サンドボックス環境での十分なテストと、適切なガードレールの設計が推奨されています。
この考え方は、状態Cのように自律性の高い使い方へ進むほど重要になります。状態Aは出力ひとつひとつを利用者が都度確認する使い方が中心で、状態Bはあらかじめ設計したタイミングで結果を確認する運用が中心です。ただし、これはA・Bが常に低リスクであることを意味しません。実際にどこまで確認を設計すべきかは、扱う情報の機密性や業務への影響、利用環境によって変わります。
まとめ|3つの状態のどこにいたか
| 状態 | 次に取る行動 |
|---|---|
| A|固定手順のまま人力・単発利用で十分 | 学習不要。今の使い方の幅を広げる |
| B|固定手順をノーコードで自動化したい | ノーコードツールで1つ試す |
| C|途中の判断をAIに動的に任せたい | 実行権限と人間の確認地点を設計する |
任せたい作業の対象がコードそのものである場合は、前述の別軸(プログラミング学習・コーディングエージェント)で判断してください。
どの状態も、それ自体が正しい着地点です。今の状態に合わない学習を焦って始める必要はありません。